Problem
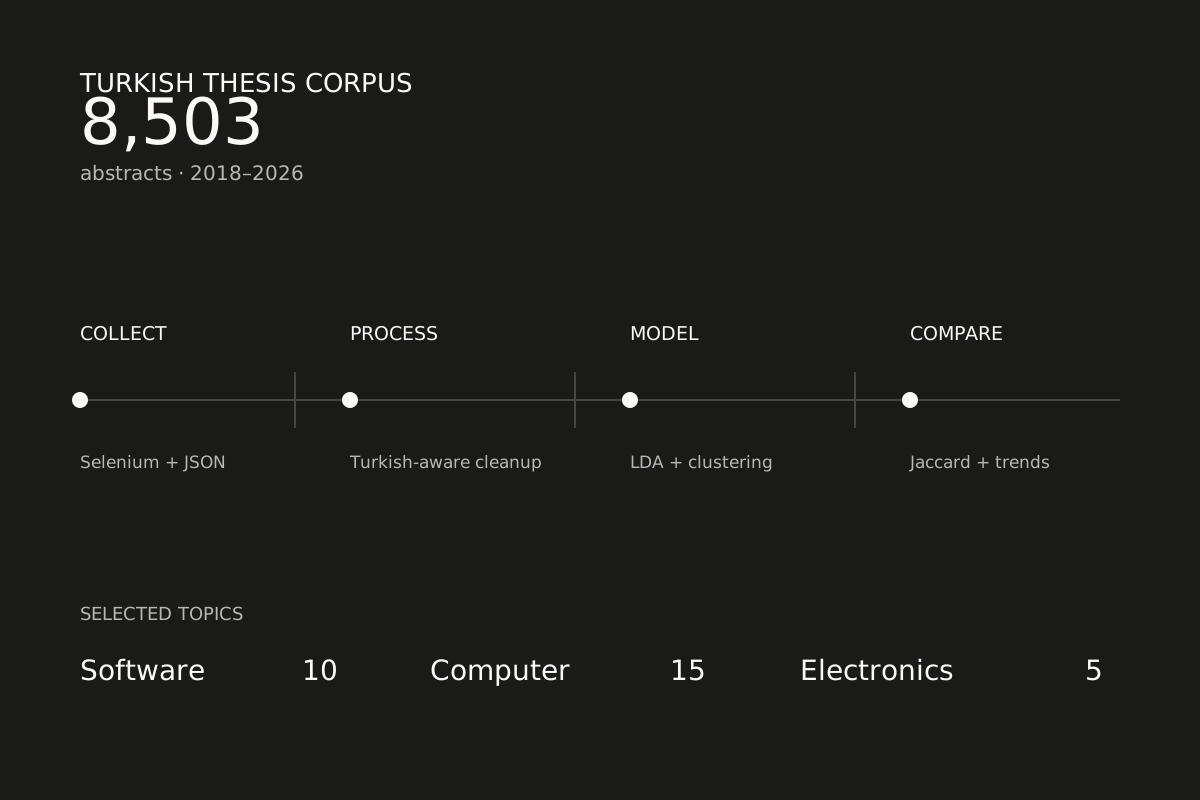
Yazılım, Bilgisayar ve Elektronik ve Haberleşme Mühendisliği tezlerinde hangi konuların çalışıldığını, bu konuların yıllara göre değişimini ve alanlar arasındaki benzerliği inceledim. Bunun için 2018–2026 dönemindeki Türkçe tez özetlerini toplayan, temizleyen ve modelleyen bir Python pipeline’ı geliştirdim.
Veri toplama ve ön işleme
Yıl bazlı sonuç sayfalarını Selenium ile taradım, tez kayıtlarını HTTP/JSON endpoint’inden aldım. Ham veriyi ön işlenmiş veriden ayrı tuttum. Türkçe ve İngilizce başlıkları ters kaydedilmiş 2850 kaydı düzelttim, 300 karakterden kısa özetleri çıkardım. Dil filtrelemesiyle İngilizce görünen özetlerin oranı %1’in altına indi.
Kalite kontrollerinden sonra veri kümesinde 8503 kullanılabilir özet kaldı: Yazılım Mühendisliği’nden 484, Bilgisayar Mühendisliği’nden 7016, Elektronik ve Haberleşme Mühendisliği’nden 1003 özet.
Modelleme ve karşılaştırma
Her alan için ayrı bir Gensim LDA modeli eğittim. Konu sayısını 5–30 aralığında deneyip c_v coherence skoru ve konu sözcüklerinin anlamlılığı üzerinden seçtim: Yazılım için 10, Bilgisayar için 15, Elektronik ve Haberleşme için 5 konu. Belge-konu dağılımlarını K-Means ve Ward hiyerarşik kümeleme ile analiz ettim. Alanlar arasındaki sözcük örtüşmesini Jaccard benzerliğiyle ölçtüm.
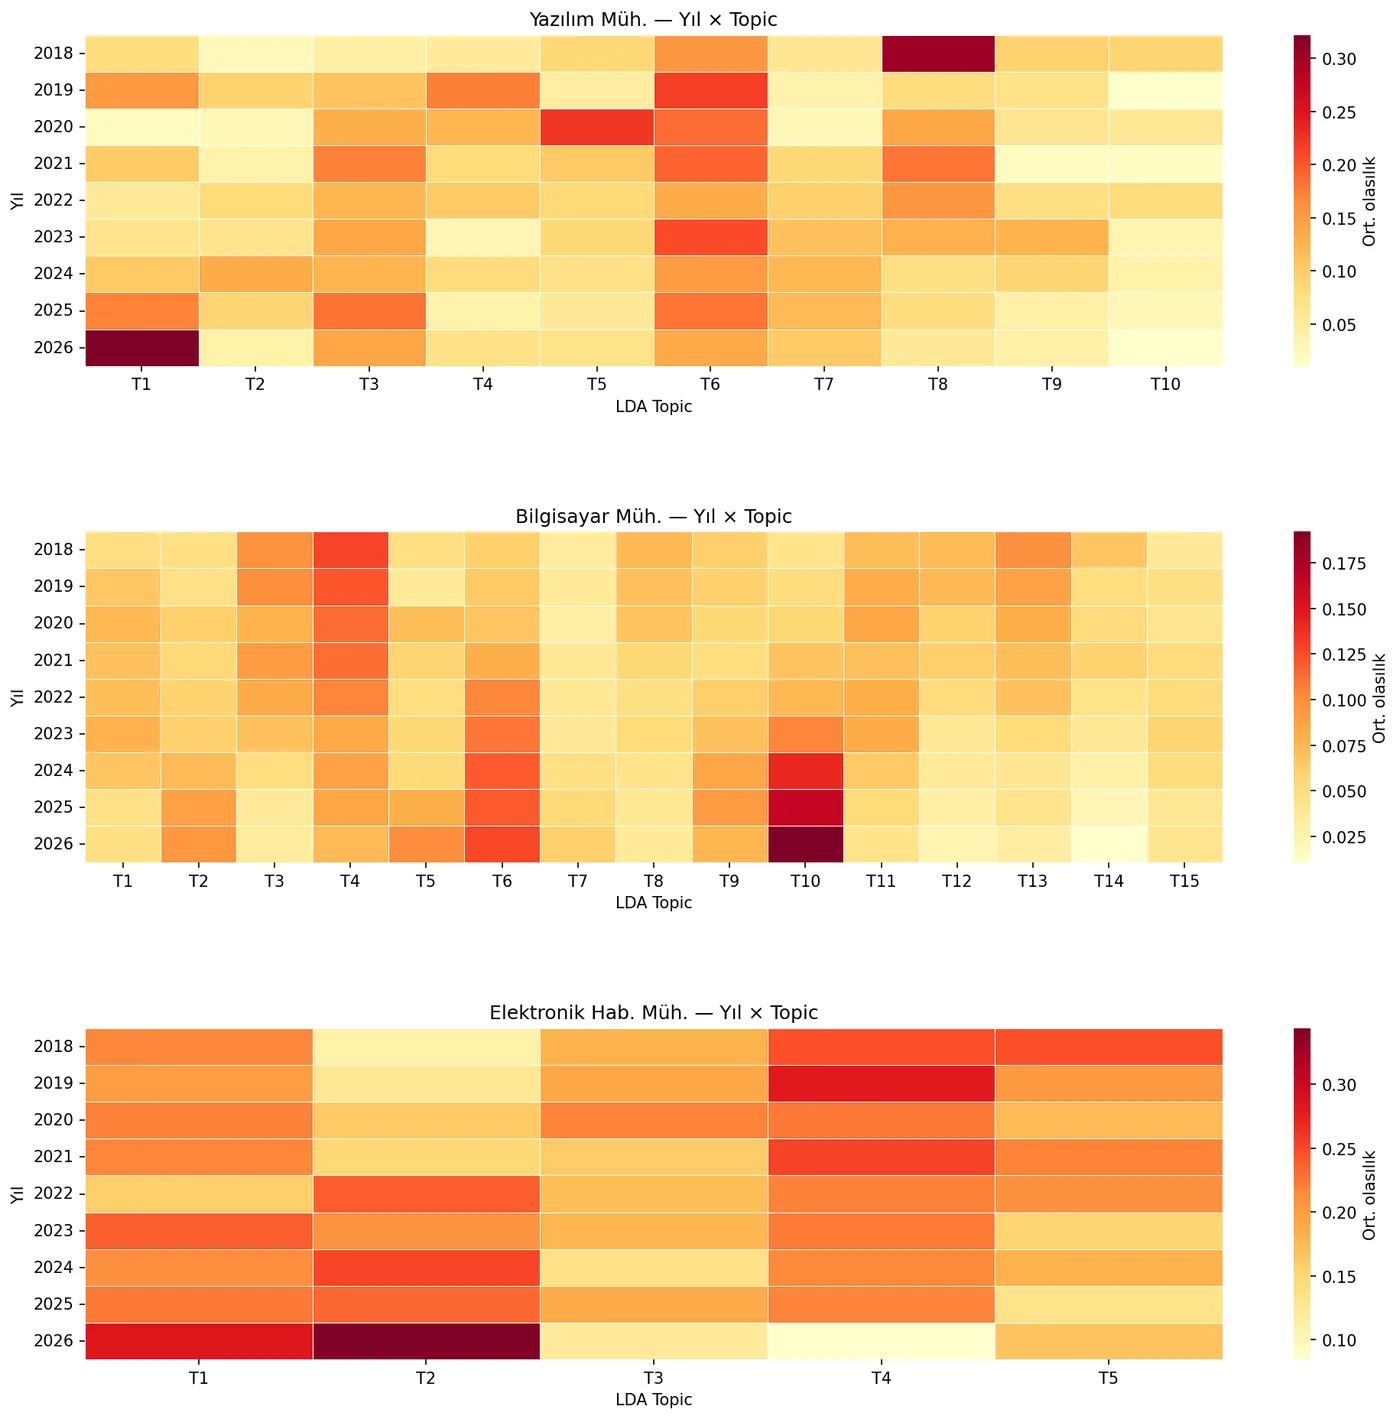
Konuların yıllara göre yaygınlığı. Tamamlanmamış 2026 verisi, eğilim hesaplamalarına dahil edilmedi.
Ön işleme ve kümeleme sorunları
Stemming denemesinde bazı Türkçe sözcükler fazla kısaltıldı ve teknik terimler anlam kaybetti. Bu nedenle sözcükleri koruyup ek varyasyonlarını dikkate alan stop-word filtrelemesi kullandım. Kısa veya riskli köklerde yalnızca tam eşleşme uygulayarak veritabanı, yerel ve zamanlama gibi terimlerin yanlışlıkla silinmesini önledim.
Kümeleme skorları, küme sayısı LDA konu sayısına yaklaştığında yükseliyordu. Belge vektörlerinin çoğunda tek konu baskın olduğu için kümeleme, LDA sonucunu büyük ölçüde tekrar ediyordu. Daha genel araştırma temalarını karşılaştırmak için küme sayısını altıda sabitledim; bunu konu sayısını belirleyen ek bir yöntem olarak kullanmadım.
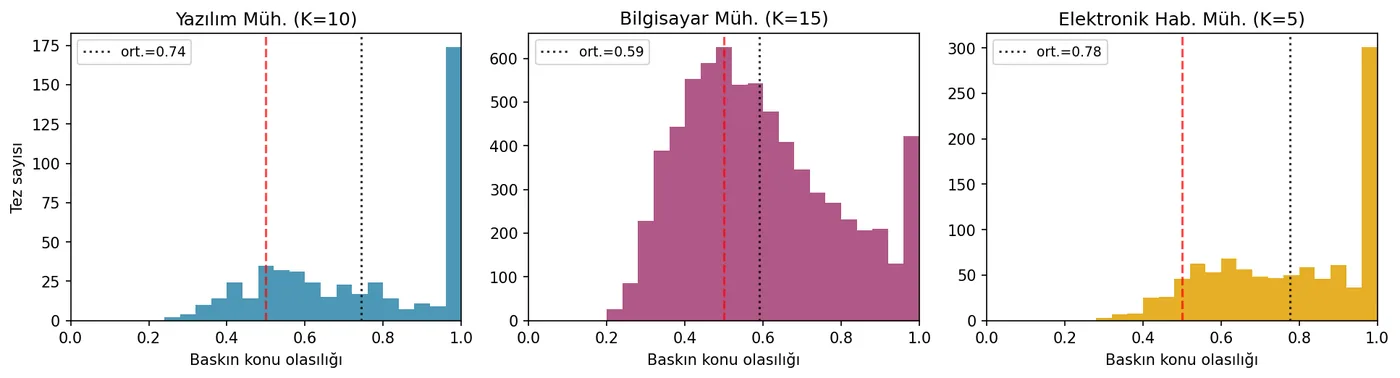
Alanlara göre ortalama baskın konu olasılığı 0,59–0,78 arasında. Bu yoğunlaşma, kümeleme sonuçlarının LDA atamalarına benzemesini açıklıyor.
Sonuç
Yazılım ve Bilgisayar Mühendisliği, 0,373 Jaccard skoruyla en güçlü sözcük örtüşmesini gösterdi. Elektronik ve Haberleşme Mühendisliği daha ayrışmıştı: Yazılım Mühendisliği ile 0,112, Bilgisayar Mühendisliği ile 0,123 benzerlik elde edildi. 2018–2025 arasında derin öğrenme ve biyomedikal görüntüleme temaları artarken klasik makine öğrenmesi ve örüntü tanıma temaları azaldı.
Alanlardaki veri sayıları eşit değil. LDA, bag-of-words yaklaşımı nedeniyle sözcük sırasını ve bağlamı kullanmıyor. Jaccard da sözcük eşleşmesine dayandığından farklı terimlerle anlatılan benzer konuları kaçırabiliyor.