Problem
Verinin büyük bölümü normal kalp atımlarından oluştuğunda, bir model yüksek accuracy elde ederken nadir sınıfları kaçırabilir. Dört kişilik ekip çalışmamızda beş PyTorch mimarisini bu nedenle yalnızca genel doğrulukla değil, her sınıfa eşit ağırlık veren macro F1 ile karşılaştırdık. Amaç, daha büyük bir modelin hangi koşulda gerçekten daha iyi sonuç verdiğini görmekti.
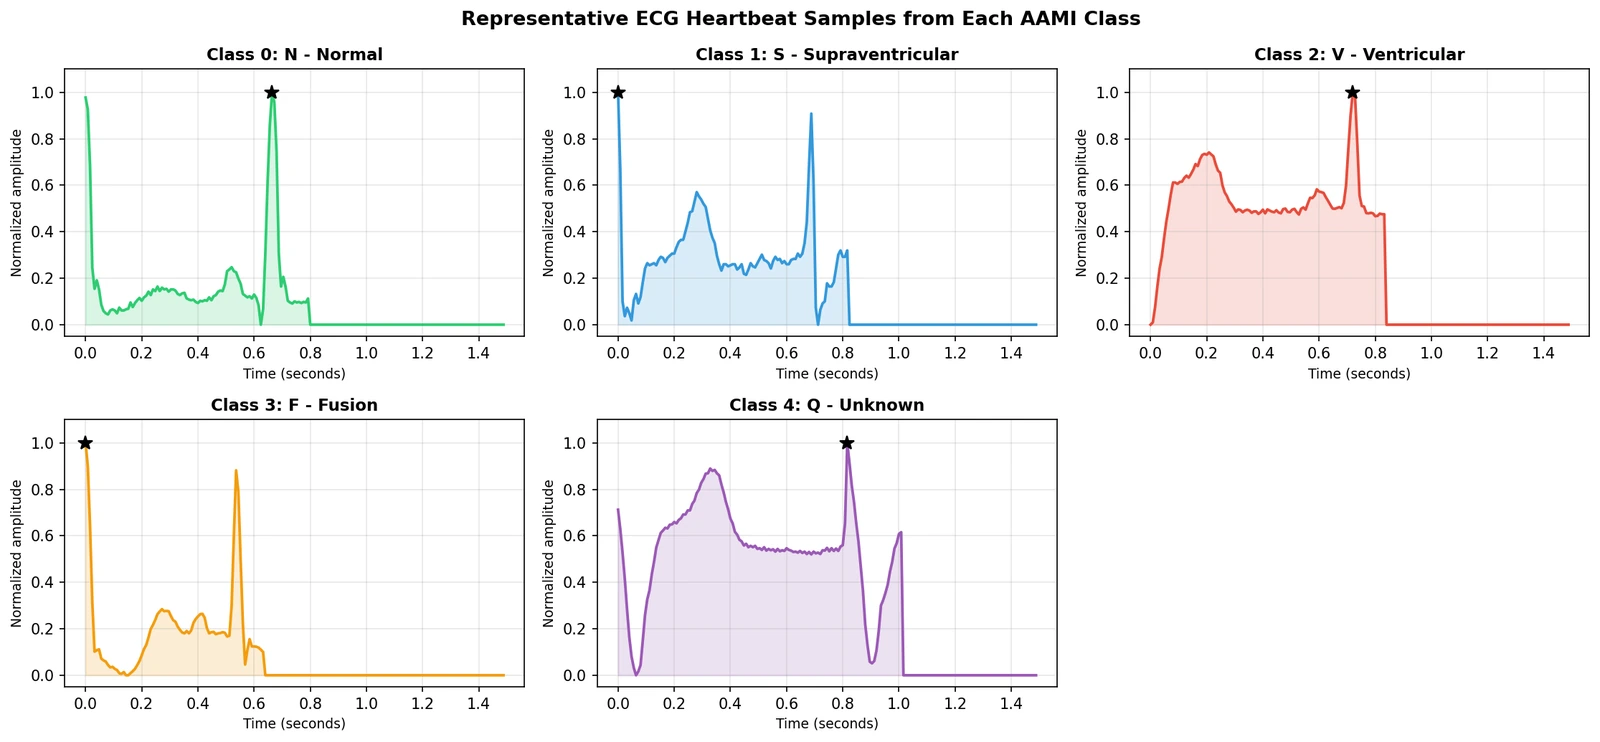
Hazır ön işlenmiş MIT-BIH verisinde 187 değer uzunluğunda tek kanallı segmentler kullanıldı. Görev, N, S, V, F ve Q olmak üzere beş atım sınıfını tahmin etmek. Çalışma offline bir benchmark; giyilebilir cihaza dağıtılmış bir teşhis sistemi değil.
Mimari ve deney düzeni
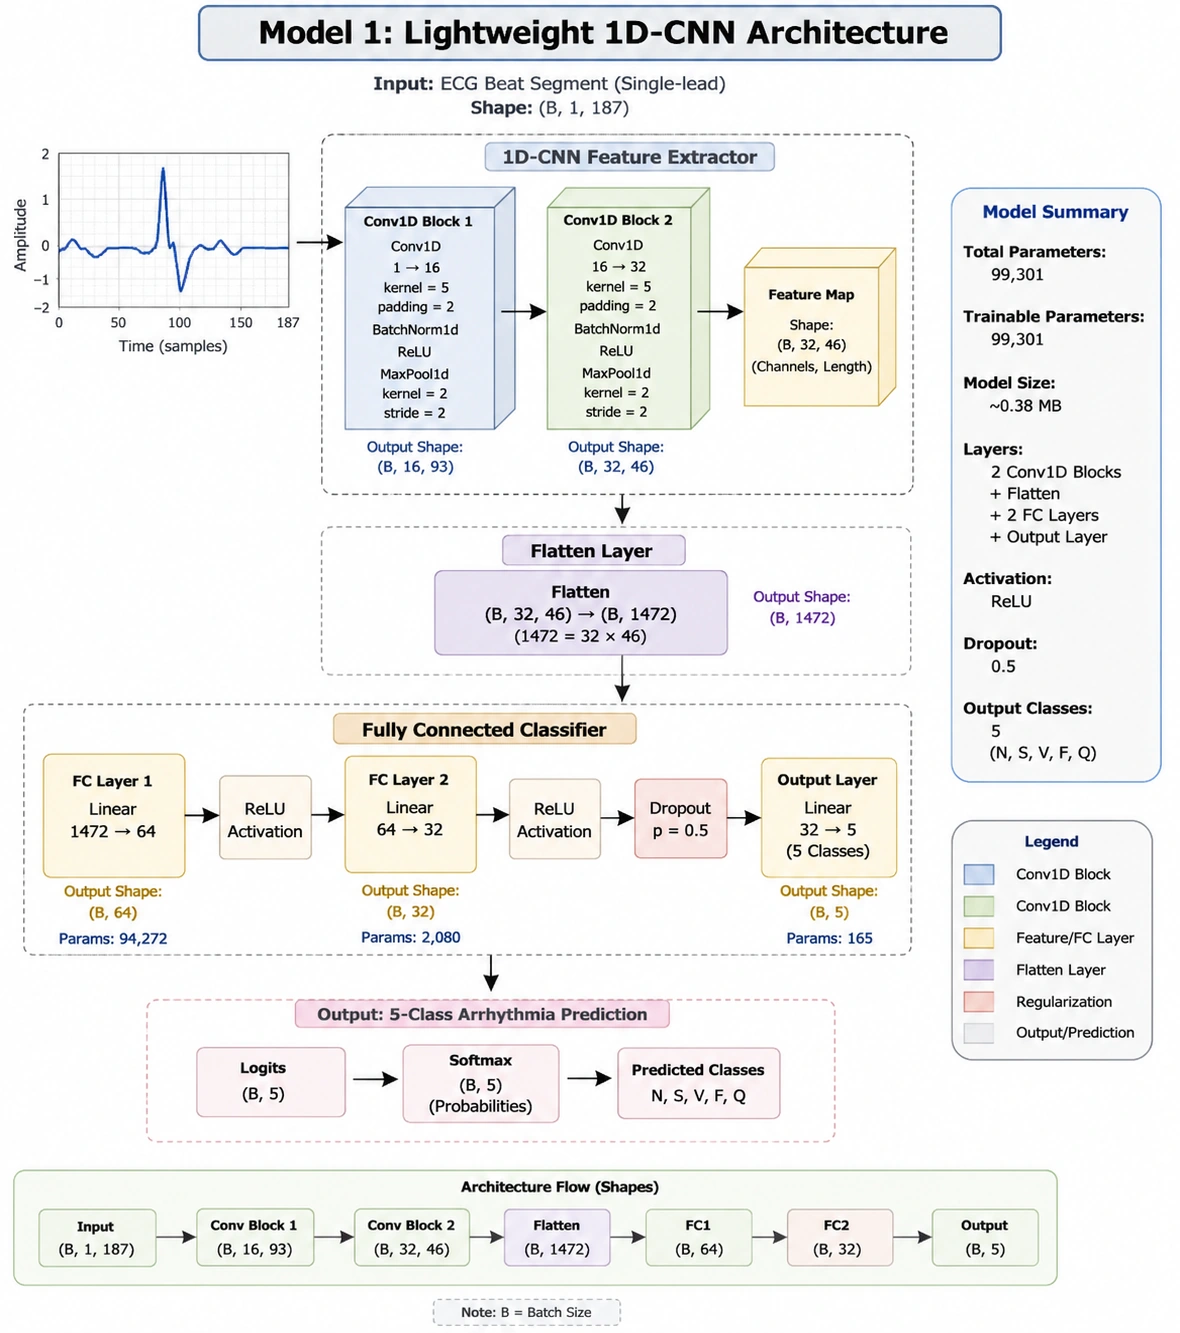
- 1D-CNN: Conv1D, BatchNorm, pooling ve dense sınıflandırıcı.
- CNN-BiLSTM: yerel CNN özellikleri ile çift yönlü sıralı modelleme.
- CNN-CBAM-BiLSTM: channel ve spatial attention eklenmiş hibrit yapı.
- MAB-Net: depthwise separable convolution, SE attention ve BiLSTM.
- CAT-Net: CNN, channel attention ve Transformer encoder.
nn.Module ve Dataset sınıfları kalıtımla özelleştirildi; attention ve convolution blokları composition ile birleştirildi. Eğitimde weighted CrossEntropy, dropout, early stopping ve checkpoint kullanıldı. OFAT deneylerinde bir hiperparametre değiştirilirken diğerleri sabit tutuldu.
Sonuçlar
| Yapı | Test accuracy | Macro F1 |
|---|---|---|
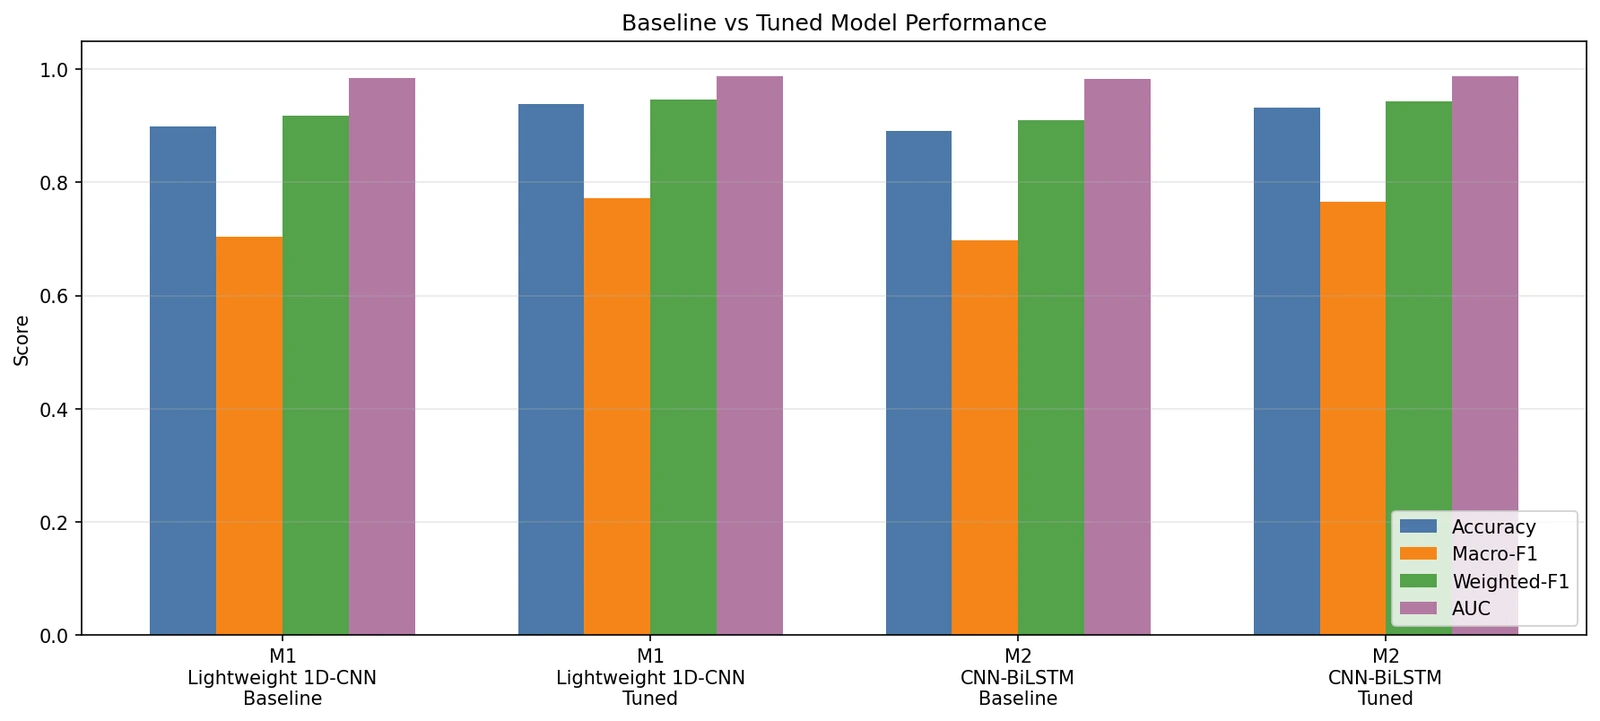
| Tuned 1D-CNN | %93,89 | 0,7719 |
| Tuned CNN-BiLSTM | %93,23 | 0,7664 |
| CNN-CBAM-BiLSTM | %85,92 | 0,6536 |
| MAB-Net baseline | %93,70 | 0,7906 |
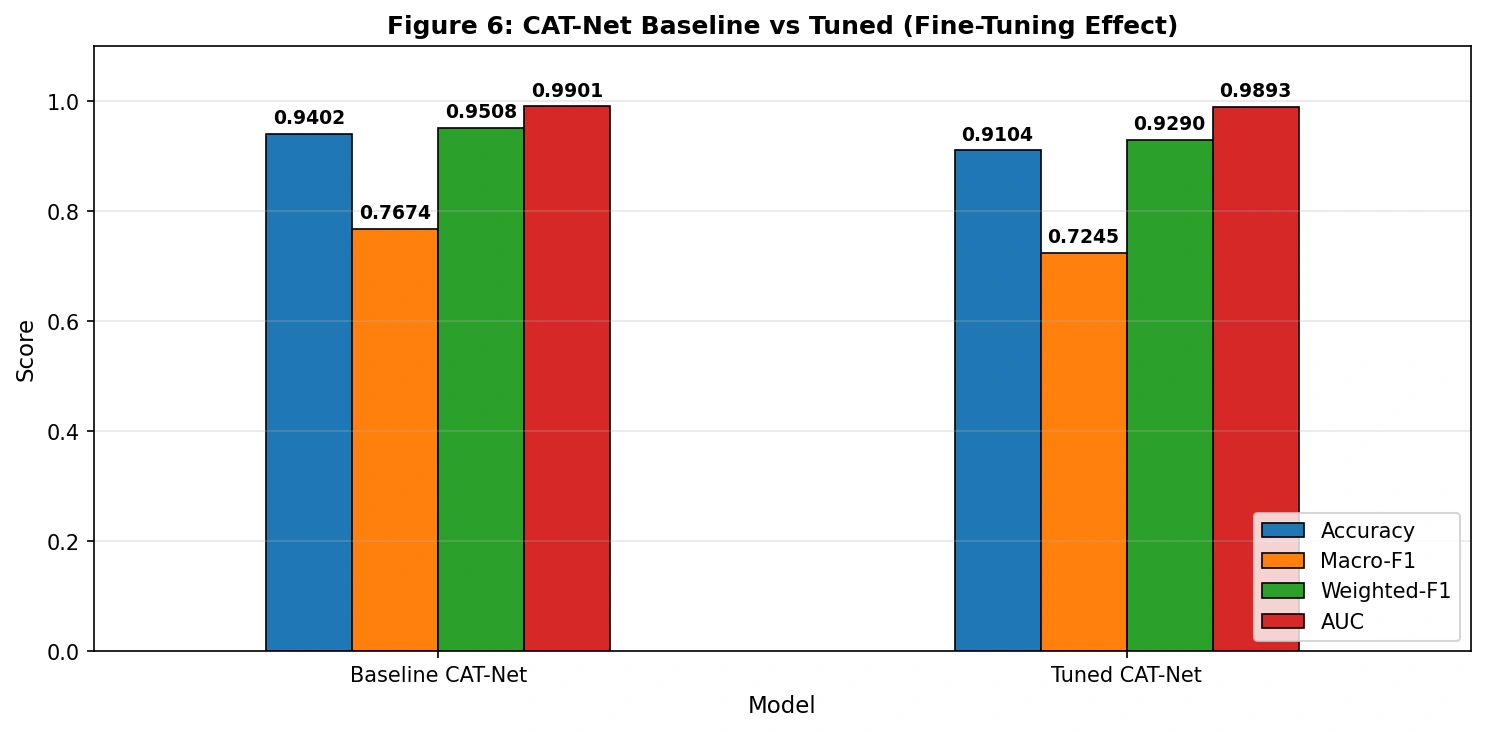
| CAT-Net baseline | %94,02 | 0,7674 |
Bunlar rapor ve kayıtlı notebook çıktılarındaki ekip sonuçları. MAB-Net macro F1’da, CAT-Net accuracy’de öne çıkıyor. CAT-Net’in tuned sürümünde macro F1 0,7245’e düştü; tek tek seçilen iyi parametrelerin birlikte aynı sonucu vermediğini gözlemledik.
Sınırlar ve çıkarımlar
Model 3, diğer notebook’lardan farklı olarak stratified split yerine random_split kullanıyor. Karşılaştırmayı daha kontrollü yapmak için bölmeler eşitlenmeli. Hasta kimliğine göre ayrı validation ve gerçek cihaz gecikme/enerji ölçümleri de mevcut değil.
Çalışma mevcut kalp atımı segmentini sınıflandırıyor; gelecekteki bir olayı önceden tahmin etme başarısını ölçmüyor. En önemli sonuç, model seçiminde accuracy, azınlık sınıf başarısı ve parametre sayısını birlikte değerlendirmek gerektiği. Daha karmaşık attention yapısı bu deneylerde her zaman daha iyi sonuç vermedi.